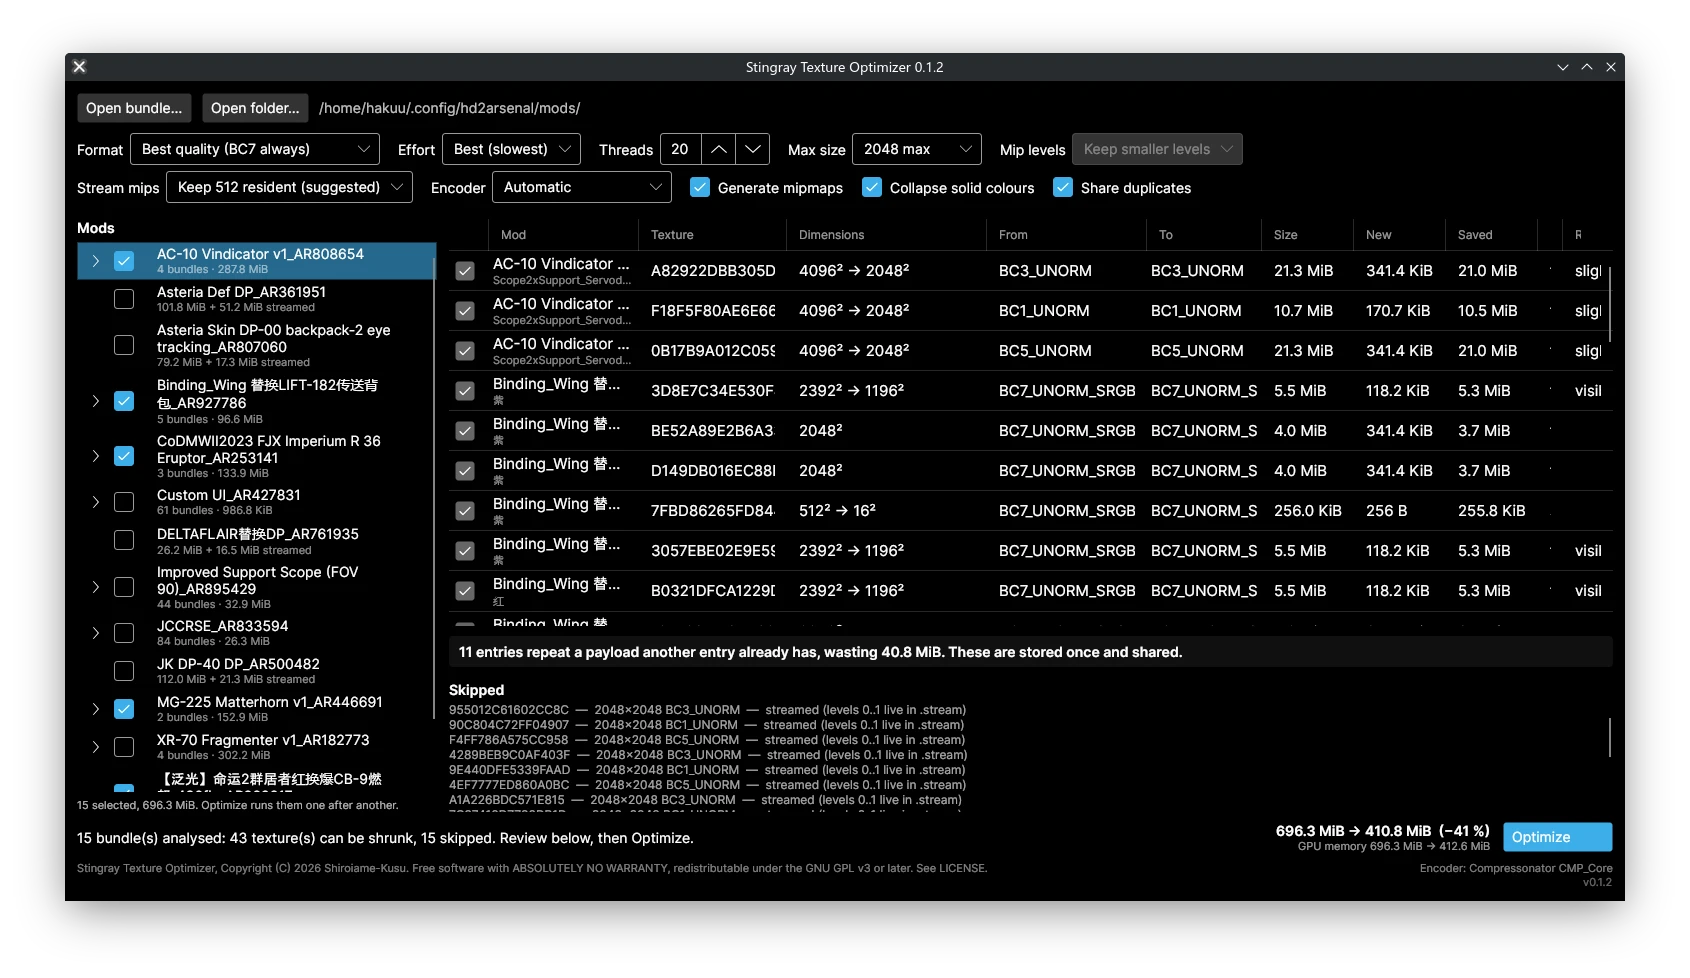
黄貂鱼纹理优化器
压缩模组的纹理。
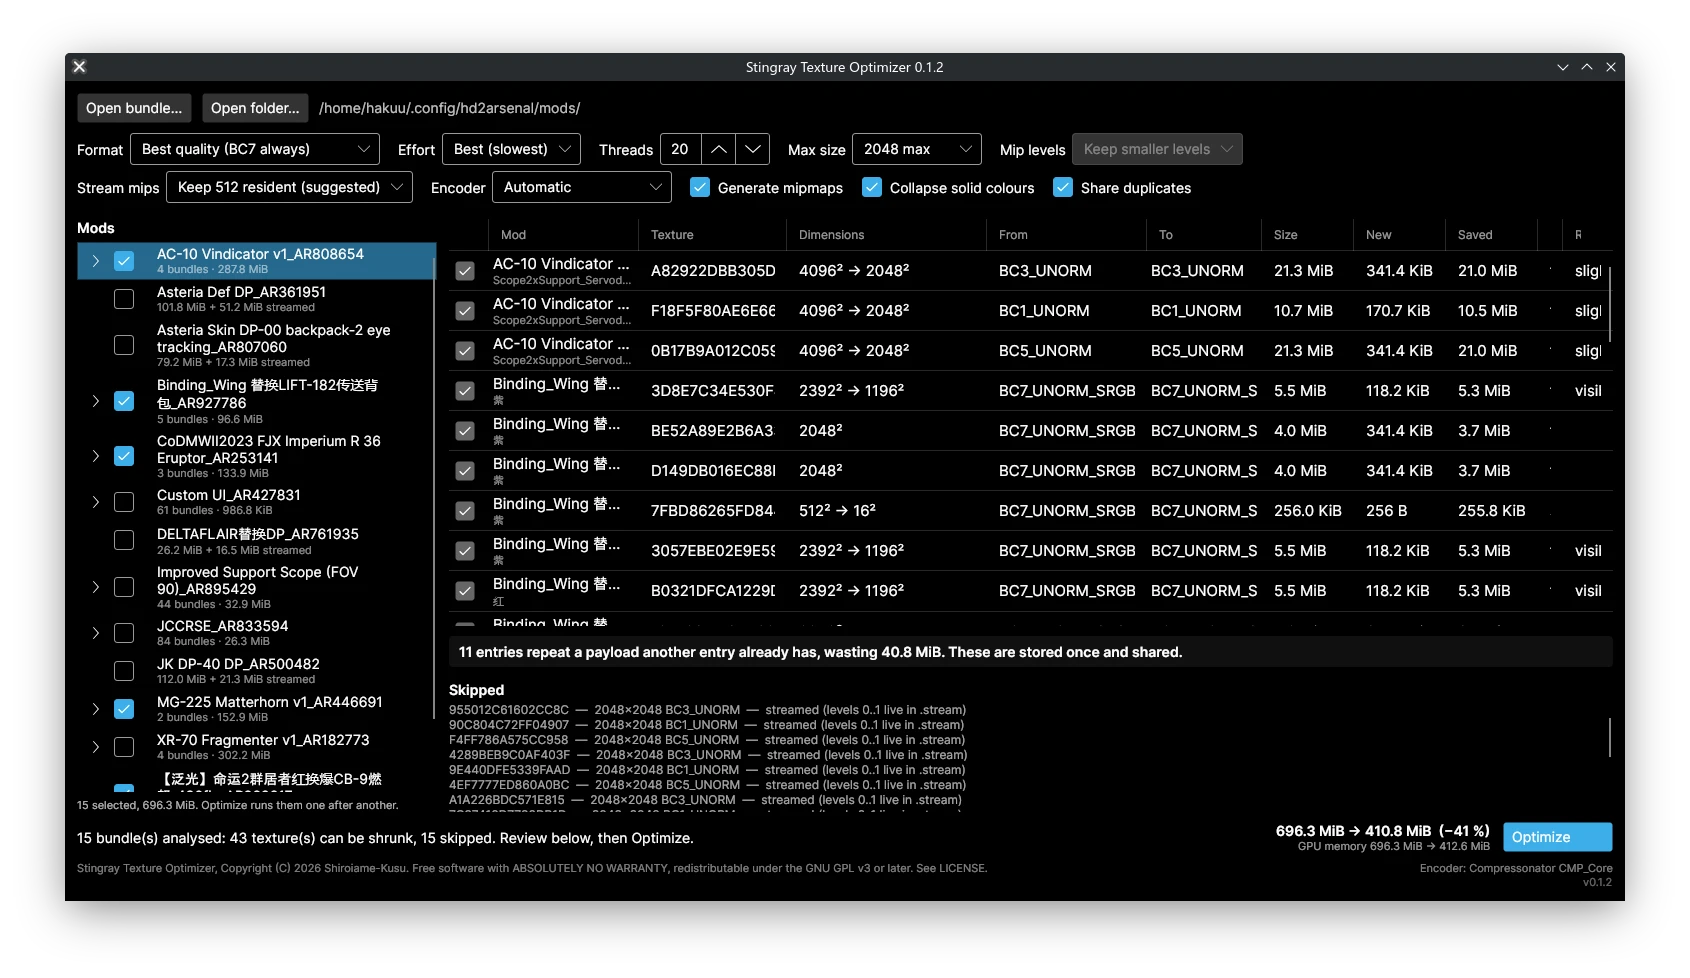 查看大图
[size=6][b]Stingray Texture Optimizer[/b][/size]
[b][size=4][url=https://github.com/Shiroiame-Kusu/StingrayTextureOptimizer]源代码在此[/url][/size][/b]
[b][size=4][url=https://github.com/Shiroiame-Kusu/StingrayTextureOptimizer/blob/master/CHANGELOG.md]更新日志[/url][/size][/b]
[quote]我做了这个应用,因为有些模组的 [color=#e4e4e7]gpu_resources[color=#a1a1aa] 文件已经超过 500 MB,把它们加载进游戏还会额外占用大约 0.5 GB 的显存。[/color][/color]
而这里有个小问题:
我的 RTX 4060 只有 8 GB 显存。
一进入游戏,我的显存占用就超限了,游戏立刻开始卡顿。
文件格式解析和核心功能是我自己设计并实现的。AI 只是一个强大的工具。我真正用它做的唯一一件事就是构建 GUI,而且它生成的每一行代码我都亲自审查过才使用。
我是懒,不是蠢。😎
祝玩得开心![/quote][color=#D4D4D8]通过对其中纹理进行块压缩来缩小 Stingray/Bitsquid 游戏包。[/color]
[b]对于所有玩模组的人[/b],你们的显卡因为安装的模组携带了数百兆字节的纹理而显存耗尽。你不需要制作过模组才能使用它,也不需要请求许可:它对你下载的模组和对你自己编写的模组一样有效,并且它会保留备份,以便你随时还原。
[b]对于模组作者[/b],你们的
[code].gpu_resources[/code] 已经膨胀,而你们宁愿发布更小的东西,也不愿让每个玩家去应付它。
[color=#D4D4D8]
适用于 Helldivers 2、Darktide 和 Vermintide 2 的包 —— 即 [/color]
[code]<hash>.patch_N[/code][color=#D4D4D8] + [/color]
[code].gpu_resources[/code][color=#D4D4D8] 组合。[/color]
[heading][color=#D4D4D8][size=4]结果[/size][/color][/heading]
[color=#D4D4D8]两个真实模组。“GPU” 是游戏必须在显存中持有的量,这才是当你显存不够时真正重要的数字——它与文件大小不同,参见 [url=http://localhost:63342/markdownPreview/378264696/markdown-preview-index-pikd2ab9skmpok7d96eo4bp05f.html#file-size-is-not-video-memory]文件大小不等于显存[/url]。[/color]
[table][tr][th][color=#D4D4D8]模组[/color][/th]
[th][color=#D4D4D8]磁盘[/color][/th]
[th][color=#D4D4D8]GPU 内存[/color][/th]
[/tr]
[tr][td][color=#D4D4D8]475 MiB,未压缩 RGBA8 纹理[/color][/td]
[td][color=#D4D4D8]475 → [b]174.7 MiB[/b][/color][/td]
[td][color=#D4D4D8]475 → [b]203.1 MiB[/b][/color][/td]
[/tr]
[tr][td][color=#D4D4D8]521 MiB,已全部为 BC7[/color][/td]
[td][color=#D4D4D8]521.6 → [b]114.9 MiB[/b][/color][/td]
[td][color=#D4D4D8]521.6 → [b]303.9 MiB[/b][/color][/td]
[/tr]
[tr][td][color=#D4D4D8]……同一个模组,允许 2048 上限[/color][/td]
[td][color=#D4D4D8]521.6 → [b]54.9 MiB[/b][/color][/td]
[td][color=#D4D4D8]521.6 → [b]111.9 MiB[/b][/color][/td]
[/tr]
[/table][color=#D4D4D8]前两行是[b]无损[/b]的:块压缩、折叠那些实际上是单一颜色的表面、以及仅存储一次字节完全相同的负载。只有第三行会有所损失,并且它会逐纹理报告具体损失了什么。
之后对两个包都进行了验证:每个条目都解析为与之前相同的内容,并且所有非纹理数据都字节完全一致。
对于促成这一切的那块 8 GB 显卡:第二个模组从 [b]521.6 MiB 显存无损降至 303.9 MiB[/b],如果你允许 2048 上限则为 [b]111.9 MiB[/b]。该上限将 16 个纹理减半,其中工具测得 8 个无可见损失、7 个略微柔化、1 个明显柔化——并且它会告诉你哪个是哪个,所以你可以把那最后一个保持原始大小。
为什么数字是这样[/color]
[list]
[][color=#D4D4D8][b]一个未经块压缩导出的 4096×4096 纹理正好是 64 MiB。[/b] 压缩它可缩小 4–8 倍。[/color][/]
[][color=#D4D4D8][b]整个表面往往是空的。[/b] 有一个模组有三个 4096×4096 的 BC7 纹理只持有单一颜色,每个 16 MiB,还有 120 个完全相同的纯黑 1024×1024 副本。[/color][/]
[][color=#D4D4D8][b]共享重复项能缩小文件但不能缩小显存[/b]——每个条目仍然是它自己的 GPU 资源。如果你缺的是显存,你想要的设置是 [/color]
[code]--max-size[/code][color=#D4D4D8]。[/color][/]
[/list][heading]快速开始[/heading]
四个步骤,途中你可以接受每一个默认值。
[b][size=4]1. 下载并解压[/size][/b]
从 Releases 获取适合你系统的压缩包,解压到任意位置。无需安装——没有 .NET 运行时,没有依赖项。运行
[code]stingray-tex-gui[/code]。
[size=4][b]2. 打开你的模组所在文件夹[/b][/size]
按下 [b]Open folder…[/b] 并指向你的模组管理器存放模组的位置。它会搜索底下的一切。
[img]https://staticdelivery.nexusmods.com/mods/6119/images/14884/14884-1785735800-1281657768.png[/img]
每一行都说明该模组在 GPU 内存中的开销,这正是整个工具所关注的那个数字。列表就是文件夹树,因为这是文件实际携带的唯一结构:一个发布变体的模组会把它们保存在自身下面的文件夹中,因此它们会出现在所属模组下方,而不是作为平铺列表里无法解释的名称。只有单个包的模组就是一行,而不是一个需要展开的文件夹。
如果你自己构建了模组并想要某个特定文件,[b]Open bundle…[/b] 可直接选取它——即那个[b]没有扩展名[/b]或以
[code].patch_0[/code]、
[code].patch_1[/code] 等结尾的文件。不是
[code].gpu_resources[/code];那个会为你找到。
3. 勾选你想要的内容,然后按下 Analyse
勾选一个模组会勾选其下的一切,并且按钮会统计仍未处理的数量——是 [b]Analyse 6[/b],而不只是 Analyse。按下它:
[img]https://staticdelivery.nexusmods.com/mods/6119/images/14884/14884-1785735824-108166535.png[/img]
所有被勾选的内容都会被读入一个网格。[b]Mod[/b] 列在上方给出模组名,下方给出变体名,因为像 [i]main[/i] 这样的名字本身毫无意义。右下角的合计覆盖整个选择——这里是 [b]571.7 MiB → 228.2 MiB[/b],一次性削减六个包的 60%。
还没有写入任何内容。分析只是读取。
[size=4][b]4. 阅读计划,然后按下 Optimize[/b][/size]
每一行是一个纹理。[b]Size → New[/b] 是它现在和之后的成本,[b]Content[/b] 是分析器在其内部发现的内容,左侧的勾选可以去掉你想保持原样的任何行。
[img]https://staticdelivery.nexusmods.com/mods/6119/images/14884/14884-1785735917-1064518867.png[/img]
那是单个包,也就是你点击一个模组而不是勾选它得到的结果——同一个网格,一个源。它的两个纹理结果从头到尾都是单一颜色,所以它们从 2048² 折叠到 16×16:从 16 MiB 降到每个 128 字节,并且它们在任意尺寸下采样结果都相同。按钮上方的横幅报告出现多次、现在只会存储一次的负载。
右下角是总计,[b]475.1 MiB → 174.7 MiB[/b],其下方是单独的 GPU 内存——如果你缺显存,这才是要关注的数字,因为共享重复项会缩小文件而不改变显卡所持有的内容。
按下 [b]Optimize[/b]。你的原始文件会首先被复制到包旁边的
[code]backup/[/code] 文件夹,之后结果会自动验证。
[color=#D4D4D8]
[b][size=5]我应该选择什么?[/size][/b]
[b]默认值是安全的——你直接按 Optimize 就行。[/b] 默认开启的一切要么完全无损,要么视觉上无法区分。
如果你想要更进一步,唯一值得调整的设置是 [b]Max size[/b]。它会将过大的纹理减半,这是这里唯一真正会丢弃细节的选项。它默认关闭。
[img]https://staticdelivery.nexusmods.com/mods/6119/images/14884/14884-1785509315-738377750.png[/img]
把它调到 [/color]
[code]2048 max[/code][color=#D4D4D8],[b]Resize cost[/b] 列会填入将每个纹理减半实际付出的代价,基于其自身像素测量。写着 [i]nothing visible lost[/i] 的行是白捡的。写着 [i]visible softening[/i] 或 [i]real detail lost[/i] 的行是需要斟酌的——取消左侧复选框可将其中任何一个保持原始大小。
这里它把这个模组从 521.6 MiB 降到 54.9 MiB,其显存从 521.6 MiB 降到 111.9 MiB,且正好只有一个纹理被标记为明显柔化。
这安全吗?[/color]
[list]
[][color=#D4D4D8]在任何写入之前都会备份你的原始文件。[/color][/]
[][color=#D4D4D8]结果会自动验证;如果有任何问题,工具会告诉你。[/color][/]
[][color=#D4D4D8]非纹理数据——模型、骨骼、材质——会逐字节原样复制。[/color][/]
[/list][color=#D4D4D8][b]在分享模组之前先在游戏内测试结果。[/b] 在测试完成之前保留 [/color]
[code]backup/[/code][color=#D4D4D8] 文件夹。
如果看起来有问题
通过把 [/color] 中的所有内容复制回来还原到包上即可。
[code]backup/[/code][color=#D4D4D8] 就是这样,其他任何东西都没有被修改。[/color]
[heading][color=#D4D4D8][size=5]为什么[/size][/color][/heading]
[color=#D4D4D8]从图像编辑器导出的纹理会以未压缩 RGBA8、无 mipmap 的形式落入包中:每像素 4 字节,所以一个 4096×4096 纹理正好是 64 MiB。块压缩可将其削减 4–8 倍。
更大的收益来自内容感知。模组常常发布通道完全恒定的纹理——一个填满 (127,127,255) 的未使用法线贴图槽,或者一个纯黑的遮罩。此工具会检测并折叠它们。
一个真实例子,一个 475 MiB 的模组:[/color]
[code]texture dimensions format size -> new content
DDF165B6350D7A78 4096x4096 BC7_UNORM 64.0 MiB -> 16.0 MiB flat RGB(127,127,255), alpha has 6 values
F0D0A596CB063EB5 2048x2048->16x16 BC1_UNORM 16.0 MiB -> 128 B solid RGBA(0,0,0,255)
21B4DAC1794DC6CC 4096x4096 BC7_UNORM 64.0 MiB -> 16.0 MiB full detail with alpha
85472186547F6415 4096x4096 BC7_UNORM 64.0 MiB -> 16.0 MiB flat RGB(127,127,255), alpha has 5 values
BCB6E42B5DD10AB6 2048x2048->16x16 BC1_UNORM 16.0 MiB -> 128 B solid RGBA(0,0,0,255)
692AC91F7776F3C2 4096x4096 BC7_UNORM 64.0 MiB -> 16.0 MiB full detail with alpha
D5EA2AD0D36C69DC 4096x4096 BC7_UNORM 64.0 MiB -> 16.0 MiB flat RGB(127,127,255), alpha has 5 values
total 475.1 MiB -> 203.1 MiB (saves 272.0 MiB)[/code][color=#D4D4D8]那七个纹理中有两个持有真实图像。两个是 2048² 的纯黑。
已经压缩过了?大概率还是太大
那些纹理都已正确为 BC7 的包仍然可能大部分是浪费,因为模组常常在许多 id 下发布相同的负载。第二个真实例子——182 个纹理,每一个都已经是 BC7,没有什么可重新压缩:[/color]
[code]duplicates: 164 entr(ies) repeat a payload another entry already has, wasting 357.4 MiB.
These are stored once and shared.
total 521.6 MiB -> 164.3 MiB (saves 357.4 MiB)[/code][color=#D4D4D8]其中 120 个条目是一个 1024×1024 纹理的字节完全相同副本——而这个纹理结果是纯黑。一旦分析器也能解码压缩表面,同一个包就会达到 [b]114.9 MiB 且毫无损失[/b]:共享重复项和折叠纯色表面都完全精确。
在此之上允许缩放([/color]
[code]--max-size 2048[/code][color=#D4D4D8])会把它带到 [b]54.9 MiB[/b]。[/color]
[heading][color=#D4D4D8][size=5]安装[/size][/color][/heading]
[color=#D4D4D8]预构建二进制文件
从 Releases 获取一个压缩包。无需安装其他东西——连 .NET 运行时都不需要。[/color]
[table][tr][th][color=#D4D4D8]平台[/color][/th]
[th][color=#D4D4D8]压缩包[/color][/th]
[/tr]
[tr][td][color=#D4D4D8]Linux x64[/color][/td]
[td][code]stingray-tex-<version>-linux-x64.tar.gz[/code][/td]
[/tr]
[tr][td][color=#D4D4D8]Windows x64[/color][/td]
[td][code]stingray-tex-<version>-win-x64.zip[/code][/td]
[/tr]
[tr][td][color=#D4D4D8]macOS Intel[/color][/td]
[td][code]stingray-tex-<version>-osx-x64.tar.gz[/code][/td]
[/tr]
[tr][td][color=#D4D4D8]macOS Apple Silicon[/color][/td]
[td][code]stingray-tex-<version>-osx-arm64.tar.gz[/code][/td]
[/tr]
[/table][color=#D4D4D8]每个都包含 [/color]
[code]stingray-tex[/code][color=#D4D4D8](CLI)和 [/color]
[code]stingray-tex-gui[/code][color=#D4D4D8]。
CLI 使用 [b]Native AOT[/b] 编译:单个约 2 MB 的原生二进制文件,无运行时依赖,启动大约 1 毫秒。GUI 则改为自包含发布——Avalonia 的 [/color]
[code]DataGrid[/code][color=#D4D4D8] 既不适合裁剪也不适合 AOT,因此强行对其使用 AOT 会产生绑定悄悄损坏的二进制文件。
[size=5]从源码构建[/size]
需要 [url=https://dotnet.microsoft.com/download][/url][url=https://dotnet.microsoft.com/en-us/download].NET 10 SDK[/url]。[/color]
[code]git clone https://github.com/Shiroiame-Kusu/StingrayTextureOptimizer.git
cd StingrayTextureOptimizer
# optional but recommended: builds the fast encoder (needs cmake and a C++ compiler).
# Run once; dotnet build then copies it into the app output automatically.
./native/build.sh # native\build.ps1 on Windows
dotnet build -c Release
# optional: a Native AOT CLI build (needs clang and zlib on Linux)
dotnet publish src/Stingray.Cli -c Release -r linux-x64[/code][color=#D4D4D8]没有第一步工具仍然可用,只是使用较慢的托管编码器——GUI 的页脚和 [/color]
[code]analyze[/code][color=#D4D4D8] 输出都会说明当前使用的是哪一个。[/color]
[heading][color=#D4D4D8][size=5]用法[/size][/color][/heading]
[color=#D4D4D8][size=4]GUI[/size][/color]
[code]dotnet run --project src/Stingray.Gui -c Release[/code][color=#D4D4D8]打开一个包,查看计划,覆盖任何你不认同的逐纹理格式,然后 Optimize。原始文件会在写入任何内容之前被复制到包旁边的 [/color]
[code]backup/[/code][color=#D4D4D8] 文件夹,结果会自动验证。
[size=4]CLI[/size][/color]
[code]# See what would happen
stingray-tex analyze mymod.patch_0
# Rewrite in place (backs up to ./backup first, then verifies)
stingray-tex optimize mymod.patch_0
# Write elsewhere instead of editing in place
stingray-tex optimize mymod.patch_0 --output ./out
# Check a bundle, optionally against its pre-optimisation original
stingray-tex verify mymod.patch_0 --original backup/mymod.patch_0[/code][heading][color=#D4D4D8][size=5]选项[/size][/color][/heading]
[color=#D4D4D8]相同的设置会出现在 GUI 工具栏和命令行上。
[size=4][b]Format — [/b][/size](GUI:[i]Format[/i])
每个纹理编码为哪种块格式。同时影响大小和质量。[/color]
[table][tr][th][color=#D4D4D8]值[/color][/th]
[th][color=#D4D4D8]GUI 标签[/color][/th]
[th][color=#D4D4D8]不透明[/color][/th]
[th][color=#D4D4D8]镂空 alpha[/color][/th]
[th][color=#D4D4D8]渐变 alpha[/color][/th]
[/tr]
[tr][td][code]balanced[/code][color=#D4D4D8] [i](默认)[/i][/color][/td]
[td][color=#D4D4D8]Balanced(不透明用 BC1,有 alpha 用 BC7)[/color][/td]
[td][color=#D4D4D8]BC1[/color][/td]
[td][color=#D4D4D8]BC7[/color][/td]
[td][color=#D4D4D8]BC7[/color][/td]
[/tr]
[tr][td][code]quality[/code][/td]
[td][color=#D4D4D8]最佳质量(始终 BC7)[/color][/td]
[td][color=#D4D4D8]BC7[/color][/td]
[td][color=#D4D4D8]BC7[/color][/td]
[td][color=#D4D4D8]BC7[/color][/td]
[/tr]
[tr][td][code]smallest[/code][/td]
[td][color=#D4D4D8]最小体积(能装就用 BC1)[/color][/td]
[td][color=#D4D4D8]BC1[/color][/td]
[td][color=#D4D4D8][b]BC1[/b][/color][/td]
[td][color=#D4D4D8]BC7[/color][/td]
[/tr]
[/table][color=#D4D4D8]BC1 是 BC7 大小的一半,但使用 5:6:5 颜色端点,因此在渐变上会产生色带。BC7 几乎精确地重现任何 8 位 RGBA。
“镂空 alpha”意味着 alpha 只可能是 0 或 255——一个没有部分透明度的模板遮罩。BC1 恰好存储一位 alpha,所以那些纹理能以 BC7 一半的大小装入。任何具有渐变 alpha 的内容在所有策略下都需要 BC7。
Effort — [/color]
[code]--quality[/code][color=#D4D4D8](GUI:[i]Effort[/i])[/color]
[code]fast[/code][color=#D4D4D8] | [/color]
[code]balanced[/code][color=#D4D4D8] [i](默认)[/i] | [/color]
[code]best[/code][color=#D4D4D8]。压缩器在定稿前尝试多少次编码。[b]它从不改变输出大小[/b]——块格式是固定码率——只改变结果与源头的接近程度,以及所需时间。
在真实的 4096×4096 图像纹理上测量,12 线程:[/color]
[table][tr][th][color=#D4D4D8]格式[/color][/th]
[th][color=#D4D4D8]强度[/color][/th]
[th][color=#D4D4D8]时间[/color][/th]
[th][color=#D4D4D8]PSNR (RGB)[/color][/th]
[/tr]
[tr][td][color=#D4D4D8]BC7[/color][/td]
[td][color=#D4D4D8]Fast[/color][/td]
[td][color=#D4D4D8]16.7 s[/color][/td]
[td][color=#D4D4D8]50.62 dB[/color][/td]
[/tr]
[tr][td][color=#D4D4D8]BC7[/color][/td]
[td][color=#D4D4D8]Balanced[/color][/td]
[td][color=#D4D4D8]22.9 s[/color][/td]
[td][color=#D4D4D8]50.90 dB[/color][/td]
[/tr]
[tr][td][color=#D4D4D8]BC7[/color][/td]
[td][color=#D4D4D8]Best[/color][/td]
[td][color=#D4D4D8]54.4 s[/color][/td]
[td][color=#D4D4D8]51.24 dB[/color][/td]
[/tr]
[tr][td][color=#D4D4D8]BC1[/color][/td]
[td][color=#D4D4D8]Fast[/color][/td]
[td][color=#D4D4D8]0.3 s[/color][/td]
[td][color=#D4D4D8]37.98 dB[/color][/td]
[/tr]
[tr][td][color=#D4D4D8]BC1[/color][/td]
[td][color=#D4D4D8]Balanced[/color][/td]
[td][color=#D4D4D8]1.1 s[/color][/td]
[td][color=#D4D4D8]41.23 dB[/color][/td]
[/tr]
[tr][td][color=#D4D4D8]BC1[/color][/td]
[td][color=#D4D4D8]Best[/color][/td]
[td][color=#D4D4D8]0.9 s[/color][/td]
[td][color=#D4D4D8]41.29 dB[/color][/td]
[/tr]
[/table][color=#D4D4D8]这两种格式的表现完全不同:[/color]
[list]
[][color=#D4D4D8][b]BC7 几乎没有反应。[/b] 整个范围跨度 0.6 dB,却要多花 3.3 倍时间。[/color]
[code]Best[/code][color=#D4D4D8] 不值得;即使 [/color]
[code]Fast[/code][color=#D4D4D8] 在视觉上也无法区分。[/color][/]
[][color=#D4D4D8][b]BC1 在低端反应很大。[/b] [/color]
[code]Fast[/code][color=#D4D4D8] 相比 [/color]
[code]Balanced[/code][color=#D4D4D8] 差了 3.3 dB,这是真实、可见的差异——而 [/color]
[code]Best[/code][color=#D4D4D8] 在它之上没有任何增益。[/color][/]
[/list][color=#D4D4D8]所以在两种情况下 [/color]
[code]balanced[/code][color=#D4D4D8] 都是正确的默认值。只有在你反复迭代且一切都是 BC7 时才用 [/color]
[code]fast[/code][color=#D4D4D8];当 BC1 参与时避免用它。[/color]
[code]best[/code][color=#D4D4D8] 花费大量时间却几乎毫无收益。
[b]强度是相对于你所选的编码器而言的,而不是绝对的质量目标。[/b] 同一个词意味着不同的东西:[/color]
[table][tr][th][/th]
[th][color=#D4D4D8]Fast[/color][/th]
[th][color=#D4D4D8]Balanced[/color][/th]
[th][color=#D4D4D8]Best[/color][/th]
[/tr]
[tr][td][color=#D4D4D8]Compressonator[/color][/td]
[td][color=#D4D4D8]51.6 dB[/color][/td]
[td][color=#D4D4D8][b]54.6 dB[/b][/color][/td]
[td][color=#D4D4D8]55.4 dB[/color][/td]
[/tr]
[tr][td][color=#D4D4D8]BCnEncoder[/color][/td]
[td][color=#D4D4D8]50.9 dB[/color][/td]
[td][color=#D4D4D8]51.3 dB[/color][/td]
[td][color=#D4D4D8]51.6 dB[/color][/td]
[/tr]
[/table][color=#D4D4D8]Compressonator 在 [/color]
[code]balanced[/code][color=#D4D4D8] 下比 BCnEncoder 在 [/color]
[code]best[/code][color=#D4D4D8] 下高出 3 dB。即使你不改 Effort,切换编码器也会改变你的输出。
Threads — [/color]
[code]--threads[/code][color=#D4D4D8]编码器工作线程。默认为 [b]CPU 核心数 − 4[/b],故意留出一些核心空闲:让每个核心都饱和于 BC7 编码会让桌面会话无法使用。
Max size — [/color]
[code]--max-size N[/code][color=#D4D4D8](GUI:[i]Max size[/i])
将任何大于 N 的纹理反复减半直到符合。 [b]默认关闭——这是唯一真正有损的选项。[/b] 每个受影响的纹理都会报告其测得的细节代价,所以你可以取消勾选那些重要的。参见 [url=http://localhost:63342/markdownPreview/378264696/markdown-preview-index-pikd2ab9skmpok7d96eo4bp05f.html#resizing-and-whether-it-will-look-blurry]缩放[/url]。
Collapse solid colours — [/color]
[code]--no-collapse[/code][color=#D4D4D8] 禁用(GUI:[i]Collapse solid colours[/i])
每个像素都相同的纹理会以 16×16 重写。视觉上无损,因为恒定纹理在任何分辨率下采样结果相同。同时节省[b]文件大小和显存[/b]。仅当着色器使用 [/color]
[code]textureSize()[/code][color=#D4D4D8] 或绝对 [/color]
[code]texelFetch[/code][color=#D4D4D8] 坐标读取纹理时才禁用。
Share duplicates — [/color]
[code]--no-dedup[/code][color=#D4D4D8] 禁用(GUI:[i]Share duplicates[/i])
字节完全相同的负载只存储一次,由使用它们的每个条目引用。无损,通常是在已压缩包中最大的节省。[b]只缩小文件[/b]——参见 [url=http://localhost:63342/markdownPreview/378264696/markdown-preview-index-pikd2ab9skmpok7d96eo4bp05f.html#file-size-is-not-video-memory]文件大小不等于显存[/url]。
Encoder — [/color]
[code]--encoder[/code][color=#D4D4D8](GUI:[i]Encoder[/i])
由哪个压缩器来完成工作。[/color]
[code]auto[/code][color=#D4D4D8] [i](默认)[/i] | [/color]
[code]compressonator[/code][color=#D4D4D8] | [/color]
[code]managed[/code][color=#D4D4D8]。[/color]
[table][tr][th][color=#D4D4D8]值[/color][/th]
[th][color=#D4D4D8]GUI 标签[/color][/th]
[th][color=#D4D4D8]是什么[/color][/th]
[/tr]
[tr][td


正在加载版本记录…
正在加载评论…
评论在新手盒子客户端中发表,这里同步展示。