许多翻译
将翻译文件拆分成多个文件以清晰分离!
 查看大图
嗨,我偶尔喜欢测试一下什么可能实现,这就是那个冲动的产物。
我真的厌倦了处理超长/繁琐的翻译文件,如果你参考 1.21.1 的原版翻译,原始文本已经接近 500Kb 了……而在开发大型内容模组时你也会遇到类似的问题(假设你不是用数据生成,但即便如此规模也可能变得疯狂)。所以……
多重翻译!
这是一个小型共享库模组,允许任何模组(或资源包)将单个 语言文件拆分成几个较小的文件,而不是维护一个巨大(或多个巨大)的文件。
这实际解决了什么问题呢?
原版每个命名空间每种语言代码只加载一个文件:
assets/<namespace>/lang/<code>.json。
ClientLanguage.loadFrom 进行精确的
路径查找(String.format("lang/%s.json", code));它从不扫描 lang/
目录,因此内容较多的模组最终会生成越来越庞大、难以审查的 JSON 文件。或者更典型的是,单个巨大的“en_us.json”文件。
工作原理
ClientLanguageMixin 重定向了
ClientLanguage#loadFrom 内部的
ResourceManager#getResourceStack(...) 调用。
在获取 lang/<code>.json 的正常精确匹配堆栈后,它还会
(通过 ResourceManager#listResourceStacks)查找同一命名空间中匹配
lang/<code>_*.json 的所有资源,按文件名对这些匹配项进行排序,并按该顺序遍历它们。
翻译键按文件顺序合并,因此后面的文件在冲突时优先。
好的,我该怎么使用它?
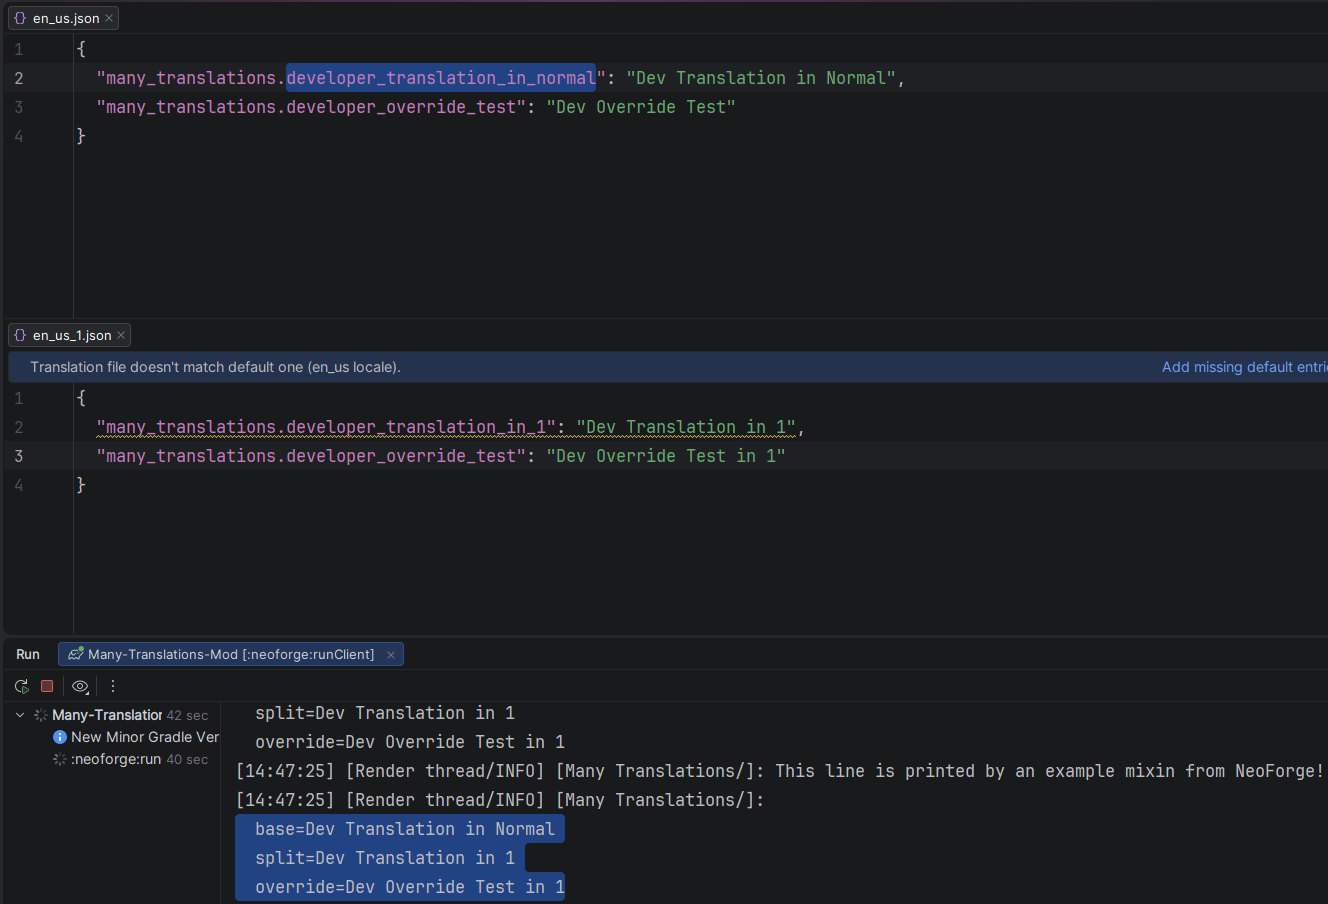
像平常一样创建你的模组!使用普通的 en_us.json 或任何你正在处理的语言代码文件,直到它变得不堪重负。
然后安装这个模组后,你可以简单地将大段内容剪切并粘贴到单独的文件中,例如 en_us_1.json 或 en_us_items.json 等。
给开发者的说明
这个模组可以通过 CurseMaven 用于开发中的工作。
正在加载版本记录…
正在加载评论…
评论在新手盒子客户端中发表,这里同步展示。