沸石
显示实体优化的隐秘等级
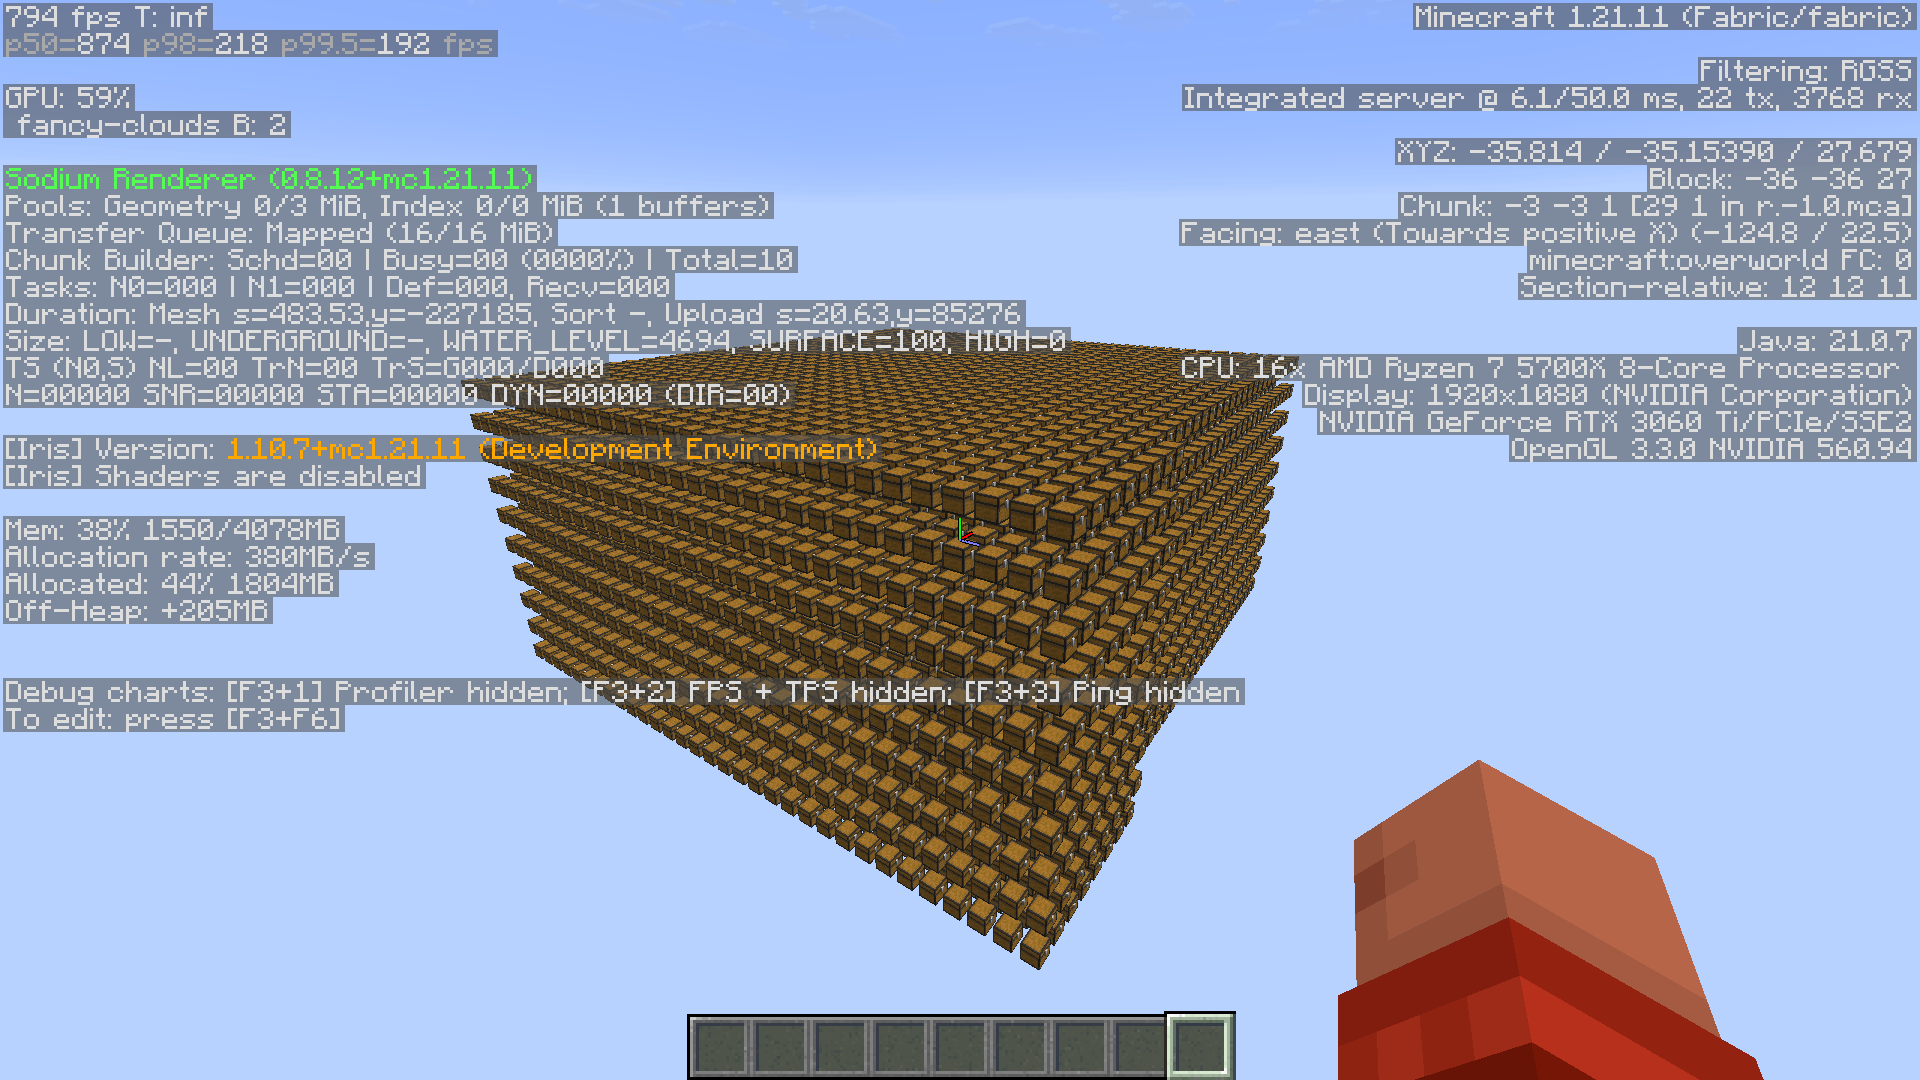
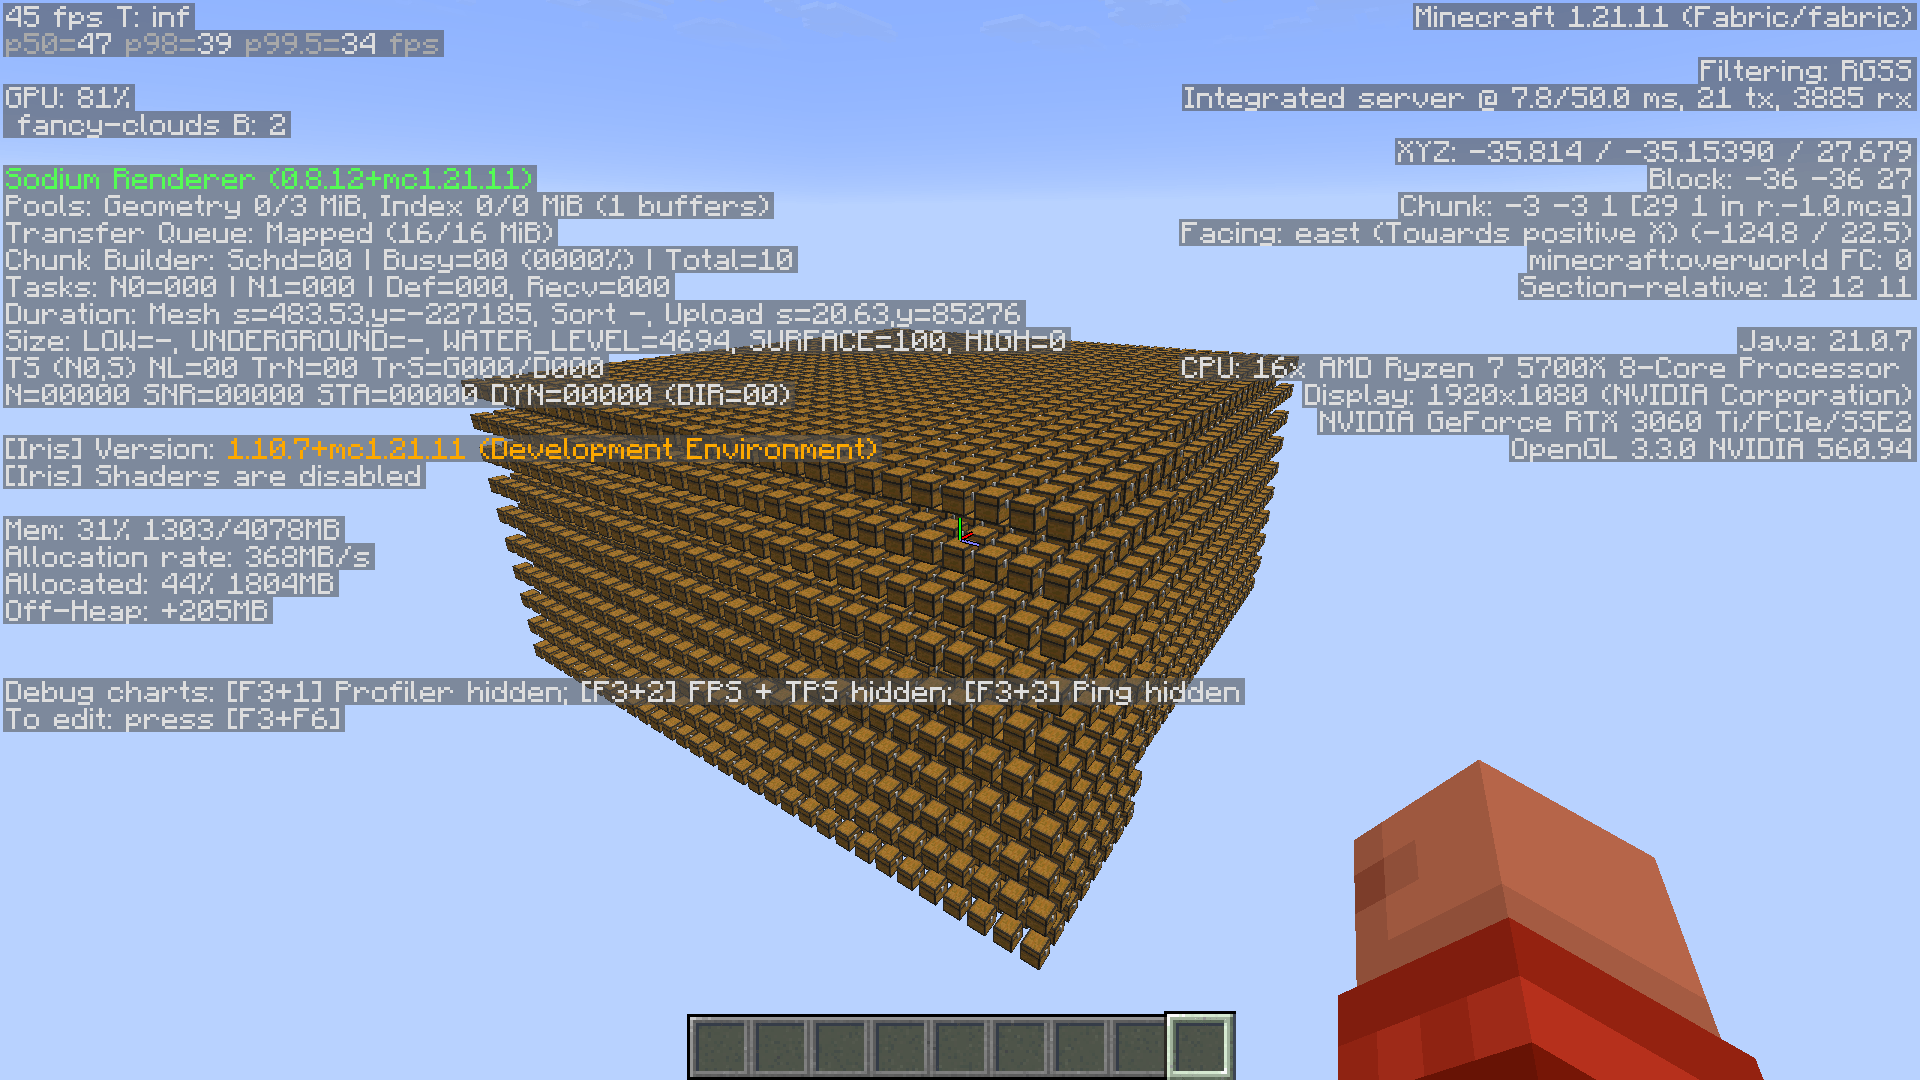 查看大图
⚡ Zeolite ⚡
前所未有的显示实体优化水平
⚠️ 早期 Alpha 版本 — 本项目仍处于早期开发阶段,目前可能会出现较多错误!
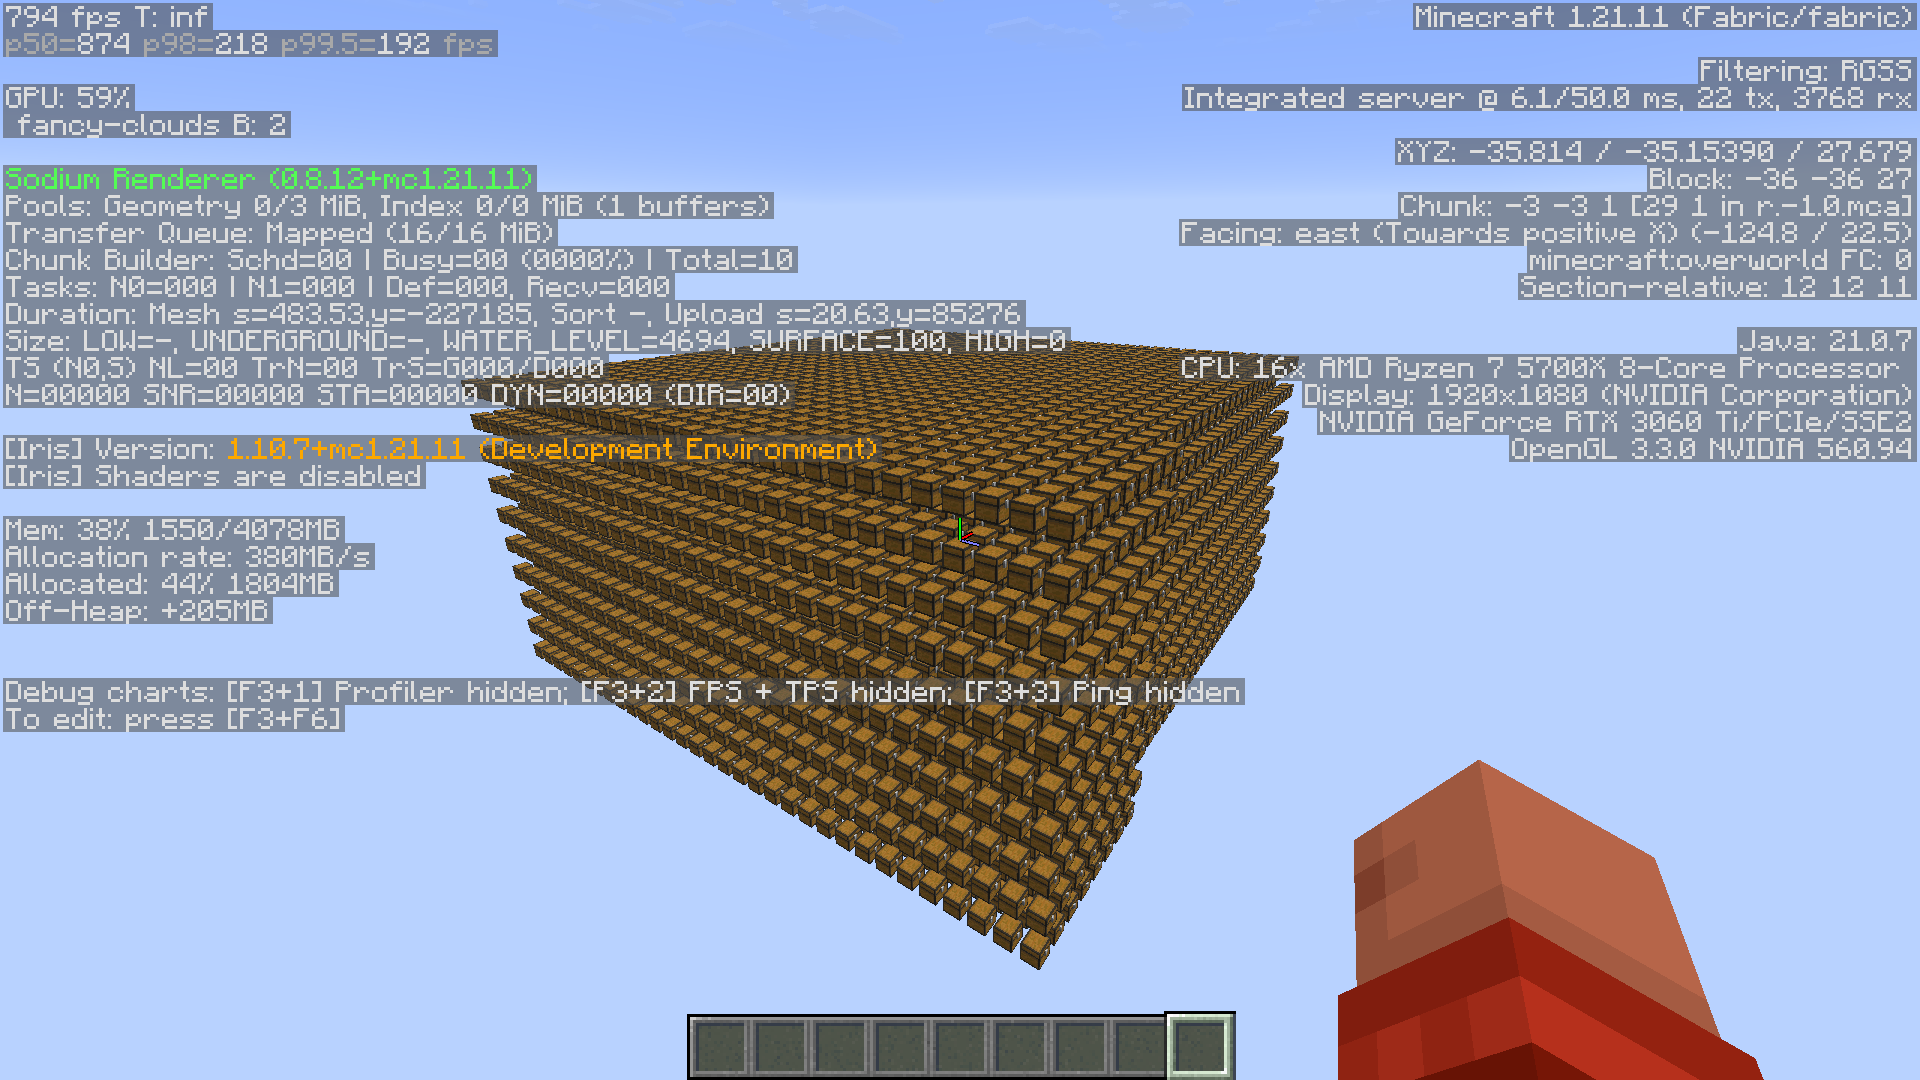
🚀 优化 🚀
| # | 优化项 | 作用 | FPS 提升 |
|---|---|---|---|
| 1 | UBO 实例化(动态层级) | 通过实例化 UBO 记录,一次绘制即可渲染模型的所有显示实体 | 58 → 1323(约 23 倍) |
| 2 | 静态层级烘焙 | 稳定的显示实体烘焙到合并缓冲区,每个材质一次绘制,每帧 CPU 零开销 | 10000 个显示实体时 CPU 每帧约 0 开销 |
| 3 | GPU 动画纹理 | 关键帧插值在 GPU 上计算,无每帧 CPU 工作 | 26 → 625(约 24 倍) |
| 4 | 动画循环锁定 | 循环动画变为自运行的 GPU 循环程序 | 锁定时 0 次上传 |
| 5 | 合并上传 + 流式环形缓冲 | 脏区域合并并通过持久映射环形缓冲区流式传输 | 491 → 625(+27%) |
| 6 | 基于内容的重新同步过滤器 | 深度比较可防止服务端冗余同步强制重新烘焙 | 0 次错误重新烘焙 |
| 7 | 网格捕获缓存 + 规范化头部模型 | 每种状态只烘焙一次;所有头颅共享一个骷髅网格 | 24 → 1712(约 71 倍) |
| 8 | 头颅皮肤图集 | 所有皮肤存储在一个图集中,头颅保持单次绘制 | 启用 #7 / #14 |
| 9 | 闪光(Glint)规范化 | 闪光作为第二层渲染,而非第二个模型 | 39 → 1549(约 40 倍) |
| 10 | 文本字形实例化 | 字形作为紧凑的实例化记录存储在分桶 UBO 中 | 20 → 116(约 6 倍) |
| 11 | 实例化阴影 | 地面阴影合并为少数几次实例化绘制 | 49600 个部件,无额外绘制 |
| 12 | 两级剔除 | CPU 按绘制组视锥剔除 + GPU 按实例剔除 | 视线移开时绘制数 → 0 |
| 13 | 原点相对坐标 | 位置相对于重设基准的渲染原点存储 | 远坐标下的浮点精度 |
| 14 | 着色静态管线(Iris) | 批次重新烘焙到光影包自身的 gbuffer 程序中 | 19 → 280(约 15 倍) |
| 15 | 光影包下的常驻重新烘焙 | 动画批次原位重写而非降级 | 光影包下保持 1 次绘制 |
| 16 | 提升预算 + 光照分带 | 提升上限和距离错开的光照刷新 | 无卡顿帧 |
🌈 光影支持 🌈
Zeolite 在 Sodium + Iris 下保持批处理 — 着色静态管线(#14)和常驻重新烘焙(#15)即使在启用光影包时也能让显示实体保持在少量绘制内。
实现这一点会带来一些 FPS 开销:
| 开销 | 原因 | 影响 |
|---|---|---|
| 安装 Sodium + Iris(光影关闭) | 即使未激活光影包,这些模组也会包裹渲染管线 — 这是它们自身的开销,并非 Zeolite 造成 | 约 20–30% FPS |
| 激活光影包 | 光影包的 gbuffer/阴影程序本身开销较大;着色静态层级可恢复大部分性能 | 使用 Zeolite 后 19 → 280(约 15 倍) |
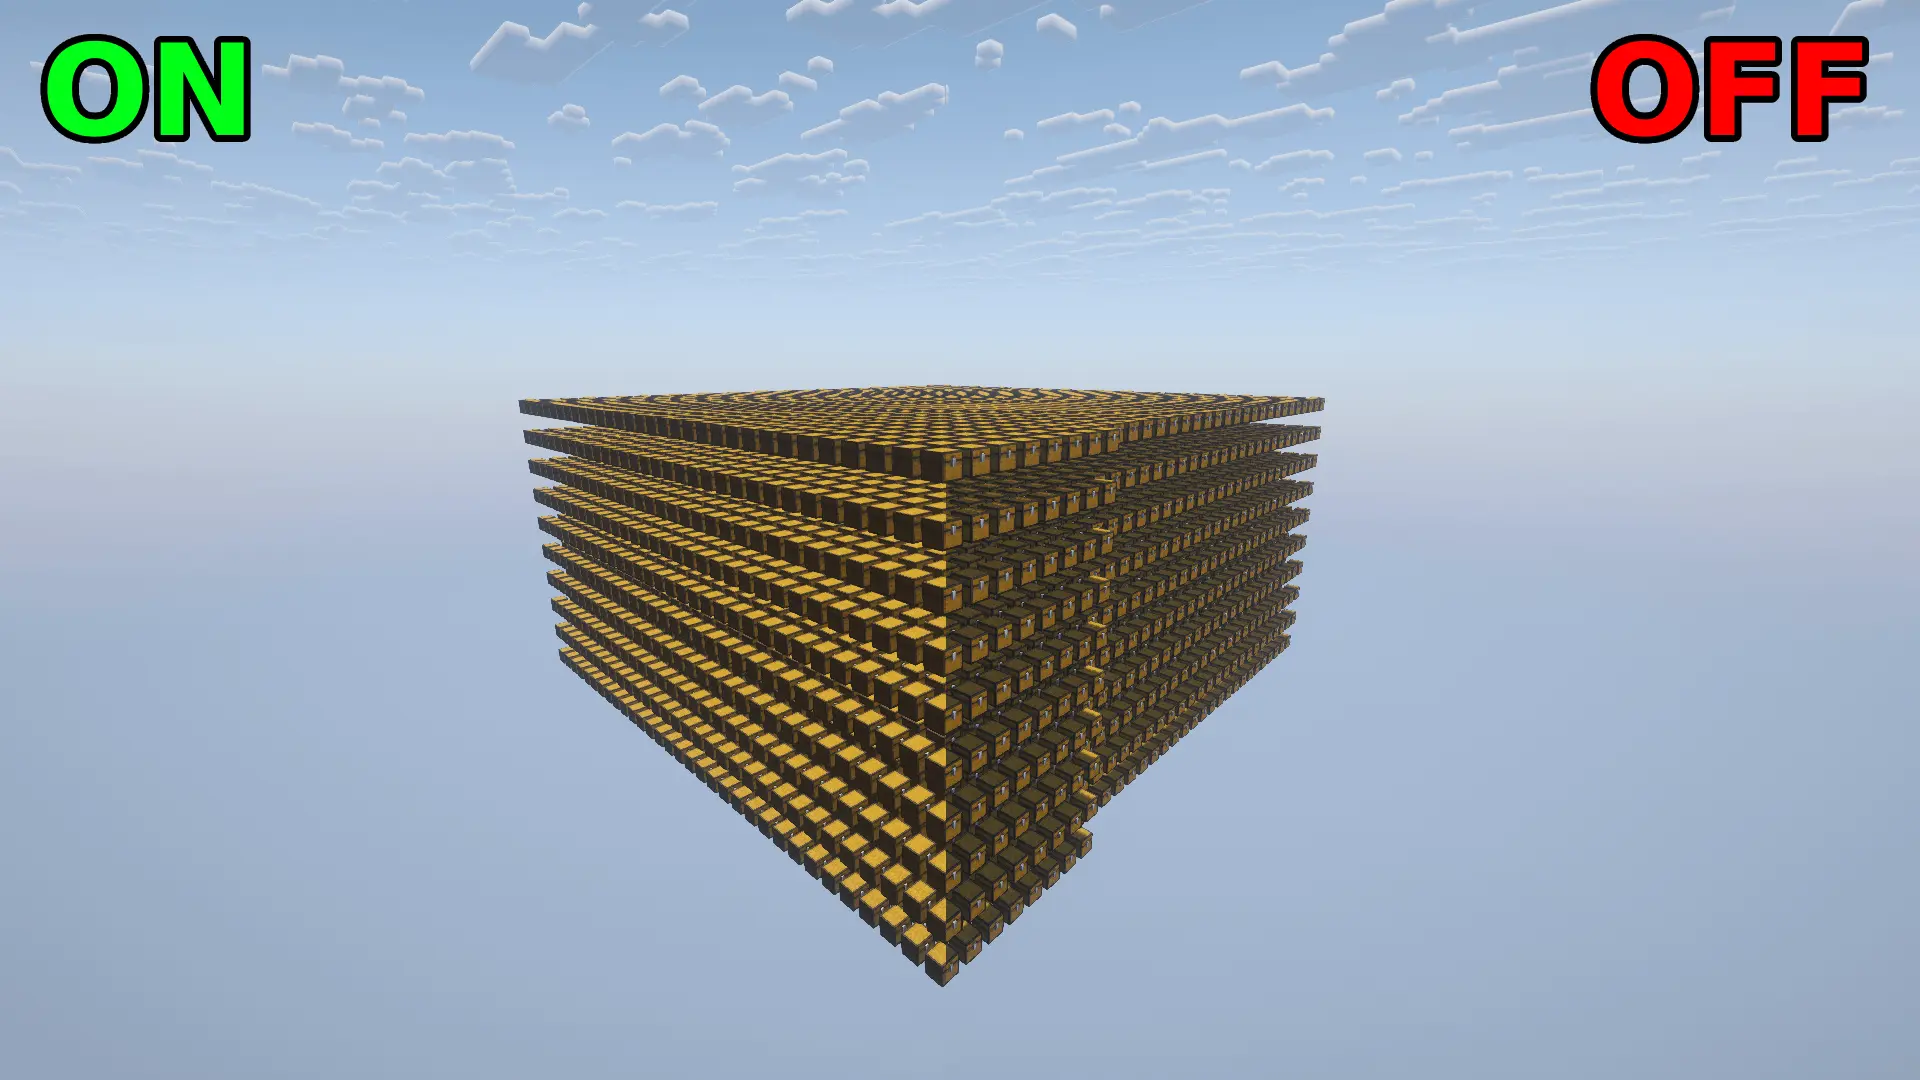
在光影包下,批处理的显示实体可能出现轻微的视觉回退:
📦 支持版本 📦
| 版本 | 状态 |
|---|---|
| 1.21.11 | ✅ 支持 |
| 26.1 | 🚧 近期可能支持 |
| 26.2 | ❌ 因 Vulkan 原因,很可能不支持 |
🛠️ 模组加载器支持 🛠️
| 模组加载器 | 状态 |
|---|---|
| Fabric | ✅ 支持 |
| NeoForge | ❌ 不支持 |
💬 社区与支持 💬
如果您有任何问题或建议,请在我们的 Discord 服务器 上告诉我们!
🐛 发现错误?请在 问题追踪器 上报告!
正在加载版本记录…
正在加载评论…
评论在新手盒子客户端中发表,这里同步展示。